Google AI検索のランキング要因13項目 — 専門家130人超が採点した「効く順」と、日本語サイトで先にやるべきこと
目次
この記事の結論:効くのは「到達できて、答えが合っていて、知られている」こと
Zyppy(Cyrus Shepard氏)が2026年9月16日に公開した「Google AI Ranking Factors」は、SEOとAI検索の専門家130人超に「Google AI OverviewsとAI Modeで、あるページや発信元が表示・選択・引用されるかに、各要因がどれだけ影響するか」を7段階(+3〜−3)で採点してもらった調査です。私が13項目の結果を読み込み、日本語サイトの実務に引き直して見えてきた要点は次の5つです。
- 上位3つは「到達性」「回答の一致」「ブランドの記憶」 — AIクロール到達性・スニペット適格性が+2.20、クエリと回答の一致が+2.15、LLMの記憶にあるブランド・エンティティが+2.08。AI固有の小技より「読めるか、合っているか、知られているか」が上に来ました
- 順位はまだ効く。ただし「ファンアウトの順位」が本クエリの順位を上回った — ファンアウトクエリでの順位が+1.91、オーガニック検索順位が+1.89。専門家は「引用されるのは順位があるから。表のクエリか、裏のサブクエリかの違い」と整理しています
- 事実は「具体的」で「独自」であることが条件 — 引用可能な具体的事実が+2.07、独自・一次情報が+1.85。同じことを言う11ページ目は引かれません。一方で「ウェブ横断の合意」も+1.81で、独自性と裏付けの両立が求められます
- 構造化データは+0.80、llms.txtは+0.05 — 「効かない」とまでは言われていませんが、上位要因とは桁が違います。チャンキング(分割)も「不要」がほぼ総意で、必要なのは見出し・表・リストで整理された普通の構造です
- 専門家自身が「まだ分からない」と言っている — 「これは古くなるだろう」「本当は『分からない』と答えるべき項目が多い」という声が併記されています。数値は2026年9月時点の専門家の見立てであり、実測ではありません
以下では、13項目の全体像、上位要因の中身、下位要因の読み方、そして日本語サイトでの優先順位の順に見ていきます。
1. 調査の概要:130人超が13項目を7段階で採点
率直に言って、この調査の価値は数値そのものより「誰が答えたか」と「何を聞いたか」にあります。回答者はAhrefs、Moz、seoClarity、Wix、HubSpotなどの所属者や、Lily Ray氏、Aleyda Solis氏、Barry Schwartz氏、Kevin Indig氏といった、英語圏のSEO業界で名前の通った実務家・研究者130人超です。
聞き方は3段階でした。
- 各要因について「Google AI OverviewsやAI Modeで、ページや発信元が表示・選択・引用されるかにどれだけ影響するか」を質問
- 7段階(+3 強い正の影響〜−3 強い負の影響)で採点
- 自由記述で補足
つまり、公開されている数値は「専門家の主観評価の平均」です。Googleの内部仕様でも、ログの実測でもありません。この前提を置いたうえで読むと、順位の並びに意味が出てきます。
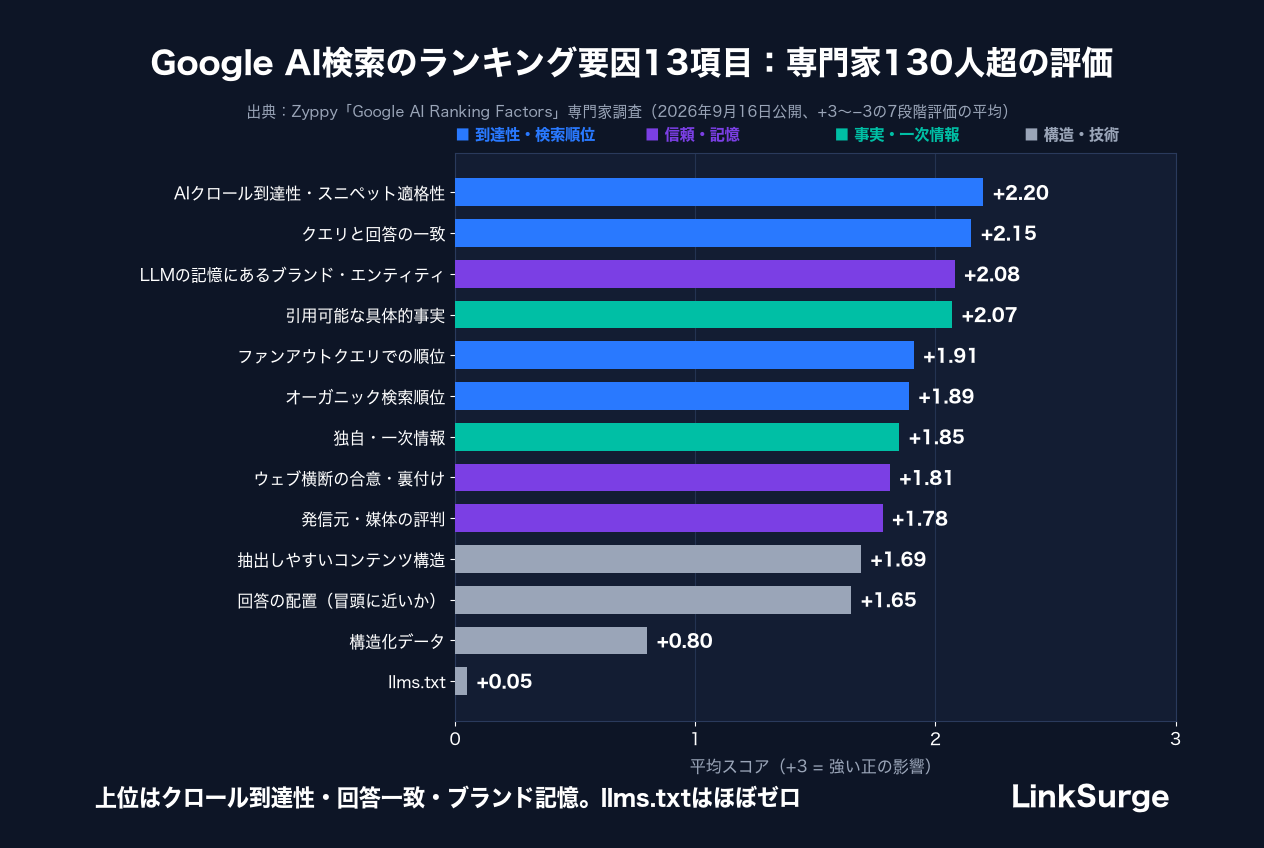
| 順位 | 要因 | 平均スコア |
|---|---|---|
| 1 | AIクロール到達性・スニペット適格性 | +2.20 |
| 2 | クエリと回答の一致 | +2.15 |
| 3 | LLMの記憶にあるブランド・エンティティ | +2.08 |
| 4 | 引用可能な具体的事実 | +2.07 |
| 5 | ファンアウトクエリでの順位 | +1.91 |
| 6 | オーガニック検索順位 | +1.89 |
| 7 | 独自・一次情報 | +1.85 |
| 8 | ウェブ横断の合意・裏付け | +1.81 |
| 9 | 発信元・媒体の評判 | +1.78 |
| 10 | 抽出しやすいコンテンツ構造 | +1.69 |
| 11 | 回答の配置(冒頭に近いか) | +1.65 |
| 12 | 構造化データ | +0.80 |
| 13 | llms.txt | +0.05 |
上位11項目は+1.65〜+2.20の範囲に収まり、差は小さい。12位と13位だけが明確に離れています。「上位はどれも効く、下の2つは別枠」という読み方が正確です。
参考・引用: Google AI Ranking Factors: What 130+ Experts Taught Us - Zyppy Signal
2. 上位3要因:到達性、回答の一致、ブランドの記憶
なぜ「クロール到達性」が1位なのか
1位のAIクロール到達性・スニペット適格性(+2.20)は、Googleがページをクロールでき、その内容をスニペットやAI生成機能に使うことを許可されているか、という要因です。Search BrothersのFili Wiese氏は「アクセスは、あらゆるランキング判断の手前にある硬いゲートだ」と表現しています。
見落としやすいのは、noindexだけでなくスニペット系の指定です。nosnippet(または max-snippet:0)が付いたページは、順位があってもAIの回答に本文を使われません。max-snippet に正の値が指定されている場合は使える文字数が制限されるだけで、data-nosnippet はマークした部分だけが除外されます。意図せず残っている指定がないかを確認してください。Googleが新しいユーザーエージェントや除外手段を増やしている今、まず自社サイトのrobots.txtとメタ指定を棚卸しすることが、どの施策より先に来ます。
「クエリと回答の一致」は従来SEOの1位と同じ
2位のクエリと回答の一致(+2.15)は、ページがユーザーの質問、あるいはGoogleが解決しようとしている質問に、どれだけ直接答えているかです。Zyppyが同時期に行った従来のGoogleランキング要因調査でも「検索意図との一致」が1位でした。Natzir氏の「一致がなければ、引用するものが何もない」という一言が、この要因の性格を言い当てています。
「LLMの記憶」は最も効いて、最も動かしにくい
3位のLLMの記憶にあるブランド・エンティティ(+2.08)は、モデルの学習データにそのブランドや人物がどれだけ強く表現されているか、という要因です。DEJANのDan Petrovic氏は、これを「パラメトリックメモリ(一次バイアス)」と呼び、「引用元として取得されていても、モデルに好かれていなければ推奨されにくい。学習データに入ることはリンク構築よりはるかに難しい」と述べています。GSC WizardのJan-Willem Bobbink氏は「ファンアウトの候補に入るには、まず検討対象として認識されている必要がある。それは記憶に基づく」と、記憶がファンアウトの入口でもあることを指摘しています。
データを見ると、この要因は「効く順」では3位ですが、「動かせる順」では最下位に近い。エンティティとして定義され、複数の情報源で一貫して語られる状態を、時間をかけて作るしかありません。エンティティ権威の作り方は「エンティティ権威がAI検索可視性を決める」で整理しています。
参考・引用: Google AI Ranking Factors: What 130+ Experts Taught Us - Zyppy Signal AI Features and Your Website - Google Search Central
3. 順位はまだ効く。ただし「表のクエリ」だけではない
5位のファンアウトクエリでの順位(+1.91)と、6位のオーガニック検索順位(+1.89)は、ほぼ同点です。面白いのは、専門家がファンアウト側をわずかに上に置いたことです。
Fili Wiese氏の説明が最も明快でした。「AI OverviewsとAI Modeは、コア検索のランキングシステムに根ざした検索拡張生成で動いている。各回答の裏でクエリファンアウトが関連サブクエリを生成する。結果は直接的だ。ページが引用されるのは順位があるからで、それが表のクエリか、裏のファンアウトクエリかの違いにすぎない」。Natzir氏は「サブクエリで上位を取ることが、文字どおり入口だ」とまで言っています。
Not a RobotのJamie Indigo氏は「オーガニック検索は、すべてのやり取りで取得を行う数少ないモデルの1つなので、AIO/AIMの検索拡張生成で大きな役割を果たす」と補足しています。順位を捨ててAI対策だけをする、という選択肢は今のところありません。
実務上の含意は「最適化の単位が変わる」ことです。Maryanna Franco氏の言葉を借りれば、「ページをクエリで上位にする」から「クエリが生む複数の情報ニーズに対して、最良の裏付け情報源になる」へ。自社の主要な問いがどんなサブクエリに分解されるかを把握し、それぞれに答える見出しを持つ。クエリファンアウトの仕組みと対策は「クエリファンアウトとは?初心者向け解説」でまとめています。サブクエリの分解パターンは、LinkSurgeのクエリファンアウト分析でも確認できます。
参考・引用: Google AI Ranking Factors: What 130+ Experts Taught Us - Zyppy Signal What is Query Fan-Out? Understanding the Hidden Queries Driving AI Search - Ahrefs
4. 事実は「具体的」で「独自」で「裏付けがある」こと
4位の引用可能な具体的事実(+2.07)、7位の独自・一次情報(+1.85)、8位のウェブ横断の合意・裏付け(+1.81)は、セットで読むべき3項目です。
PomarのGeoff Kenyon氏は「具体的な事実と一次情報は別々に評価されているが、組み合わさると特に強い。どこにでもある具体的な数字は引用を生まない。具体的で独自の事実やデータが、引用への抵抗の少ない道だ」と述べています。RicketyRooのMelissa Popp氏の言い方はもっと直接的で、「あるトピックについて同じことを言うページが10ページあるなら、11ページ目はその10ページにないものを持ち込む必要がある。独自データ、誰かが実際に走らせたテスト、直接の観察、名前と手順のあるプロセス。それが取得システムに引用すべきものを与える」。
一方で8位の「合意・裏付け」が示すのは、独自であればいいわけではないことです。自社が「うちは最高だ」と言い、他の99サイトが違うと言っていれば、AIは自社を信じません。基本的な事実は他の情報源と一致していて、そのうえで他にはない情報を1つ足す。Everett Sizemore氏は「合意は罠にもなる。皆と同じことを言っていて情報利得はあるのか。皆が間違っていたらどうするのか」と、この緊張関係をそのまま言葉にしています。
私が実務で勧めているのは、「一次情報を1つ、裏付けを2つ」の組み合わせです。自社で測った数値や検証した手順を1つ置き、その周辺の一般的な事実は権威ある情報源と一致させる。記事のどの位置に置くかより、その情報がそのブロックだけで完結しているかが引用を左右する、という点は「AI検索は記事のどこを引用するのか」の自社調査でも確認しています。
5. 下位の要因をどう読むか:構造化データ+0.80、llms.txt+0.05
抽出しやすい構造と回答の配置は「普通に大事」
10位の抽出しやすいコンテンツ構造(+1.69)と11位の回答の配置(+1.65)は、上位グループの末尾です。ここで注目したいのは「チャンキング」への評価です。Zyppyによると、回答者は「チャンキング」に計8回言及していますが、ほぼ全員が「Googleに理解させるために内容を分割する必要はない」で一致しました。そのうえで、見出し・表・リスト・整った文構造で整理されたコンテンツは「依然として極めて重要」だとしています。
回答の配置については、Agência MestreのFabio Ricotta氏の「まず質問に正面から答え、システムが労せず抽出できるように構造化する」、Search InfluenceのWill Scott氏の「人も機械も、質問への素早い答えを好む」が代表的な声です。ただし、これは「冒頭にだけ結論を置く」という話ではありません。私たちの自社調査では、AI Overviewsの実引用277件のうち、ページ最初のリード文からの引用は30.7%で、69.3%は本文中の見出しブロックからでした。各ブロックが単独で答えになっていることが、冒頭の結論より効きます。
構造化データは「ゼロではないが、桁が違う」
12位の構造化データ(+0.80)は、上位要因の半分以下です。Zyppyは「AIシステムが構造化データを読むかどうかは毎週のように新しい議論が起きているが、Googleがオーガニック順位でページ理解に使っていることは分かっており、AI回答にも少なくとも何らかの影響はあるだろう」と書いています。Andy Chadwick氏は「例外は商品・販売者データで、Shopping Graphに入り、AI Modeのショッピング結果で実際に働く」と、効く領域を限定しています。
これはGoogleの公式ガイドとも整合します。GoogleはAI OverviewsとAI Modeについて「特別なschemaは不要」と明言しており、私たちは自社ツールの評価基準からもFAQスキーマの引用率の数字を外しました。経緯は「「FAQスキーマで引用率3.2倍」は本当か」に書いています。
llms.txtは+0.05
13位のllms.txt(+0.05)は、事実上ゼロです。Local SEO GuideのAndrew Shotland氏の「llms.txtと8ドルで、まずまずのタピオカが買える」という皮肉と、Przemysław Charchan氏の「約50万ドメインを対象にした独立した7つの調査を集めたが、すべてAIボットは自発的にこのファイルを見ないという結果だった」という報告が並んでいます。
ただし、ここで言われているのは「Google AI検索の引用に効くか」です。llms.txtは、AnthropicやPerplexityなどが自社ドキュメントで公開しており、AIエージェントにサイト構造を渡す用途では実際に使われています。「検索の引用には効かない」と「用途がない」は別の話で、この切り分けは「LLMOとは何か?初心者向け完全ガイド」で整理しています。
参考・引用: Google AI Ranking Factors: What 130+ Experts Taught Us - Zyppy Signal AI 機能とウェブサイト - Google 検索セントラル
LinkSurge
linksurge.jp
SEO・AIO・GEO統合分析プラットフォーム。AI Overviews分析、SEO順位計測、GEO引用最適化など、生成AI時代のブランド露出を最大化するための分析ツールを提供しています。
6. 日本語サイトで先にやるべき順序
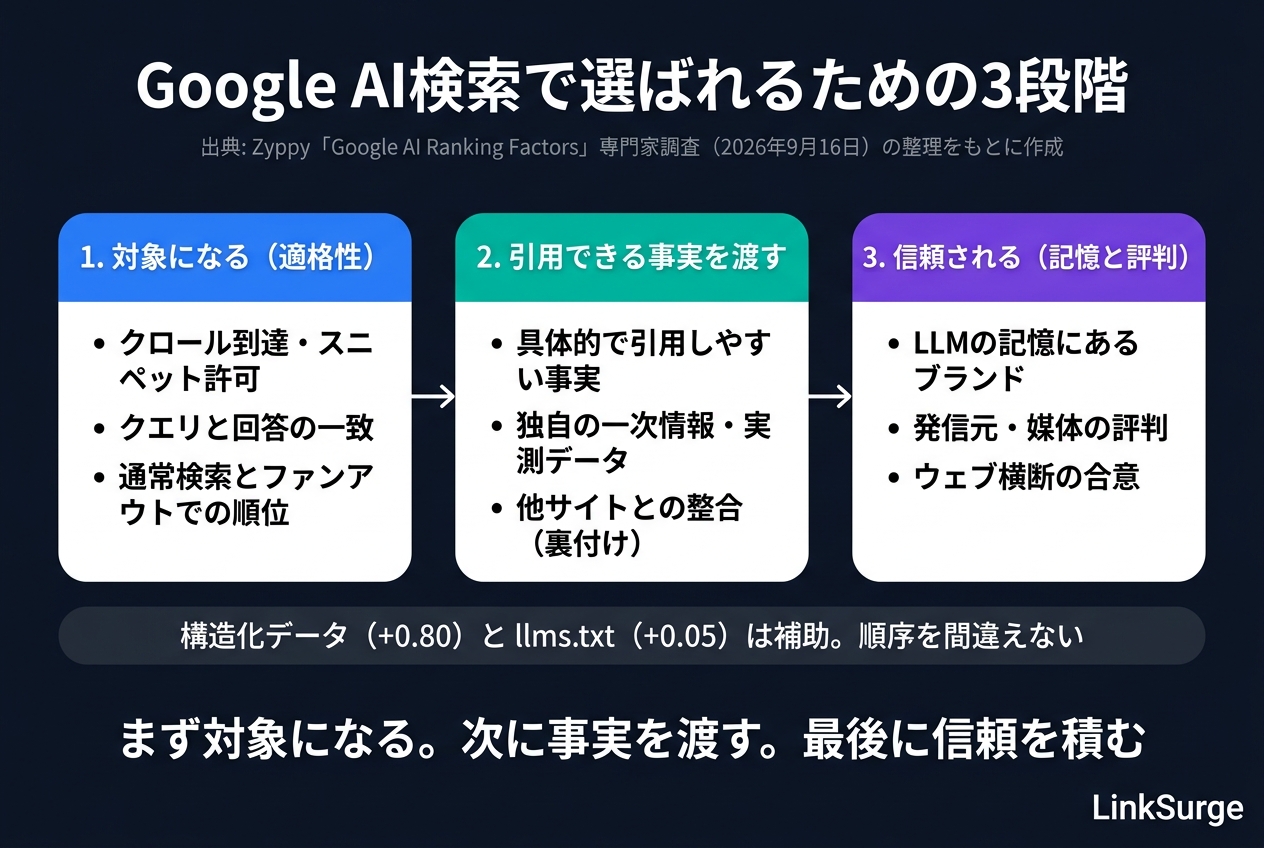
Zyppyは13項目を3段階にまとめています。「対象になる(到達性、回答の一致、順位とファンアウト)」「Googleが使える具体的な事実を渡す(具体的事実、独自情報)」「Googleに信頼される(LLMの記憶、合意、評判)」。この順序は日本語サイトでもそのまま使えますが、日本語の検索環境を踏まえて、私は次の優先順位を勧めています。
第1に、到達性の棚卸し。 robots.txt、noindex、nosnippet系の指定、JavaScript依存の本文を確認します。ここが閉じていると、以降の施策はすべて無効です。1位の要因が「硬いゲート」と呼ばれる理由です。
第2に、主要な問いへの「直接の答え」を見出し単位で持つ。 2位の回答の一致と、10〜11位の構造・配置をまとめて満たす施策です。問いごとに見出しを立て、そのブロックだけで答えが完結するように書く。冒頭に結論を置くことより、各ブロックの完結性を優先します。
第3に、ファンアウトを想定した関連トピックの網羅。 5位の要因です。主要クエリが分解されるサブクエリ(関連トピック、暗黙の疑問、比較、最新性、言い換え)を洗い出し、それぞれに答える見出しやページを用意します。
第4に、一次情報を1つ足す。 4位と7位の要因です。自社で測った数値、検証した手順、実際の事例。同じテーマの既存記事にないものを、具体的な数字と名前で置きます。
第5に、エンティティとしての一貫性。 3位、8位、9位の要因で、最も時間がかかります。会社名・サービス名・人物名が複数の情報源で同じ事実として語られる状態を作る。プレスリリース、第三者メディア、業界団体、Wikipediaなど、当事者以外の情報源での言及を増やします。
最後に、構造化データとllms.txt。 やって害はありませんが、上の5つを飛ばして取り組む理由はありません。商品を扱うサイトは、商品・販売者データの構造化だけは例外として優先度を上げてください。
どこまでできているかは、自社の主要クエリでAI Overviewsが出ているか、誰が引用されているかを見るところから分かります。LinkSurgeのAI Overview分析では、キーワードごとにAIO出現と引用元を確認できます。
7. 注意点:これは実測ではなく、専門家の見立てである
この調査を使うときに押さえておくべき制約です。
- 数値は専門家130人超の主観評価の平均で、Googleの仕様や実測データではありません。SearchPilotのWill Critchlow氏は「本当は『分からない』と答えるべき項目が多い」、HubSpotのVictor Pan氏は「これは古くなるだろう」と述べています
- 回答者は英語圏の専門家が中心で、日本語の検索結果を前提にした評価ではありません
- 要因の定義はZyppyが用意したもので、要因どうしは独立していません(例: 順位とファンアウト順位、具体的事実と一次情報)
- 「負の影響」の要因は上位13項目には現れていません。減点要因の分析はこの記事の範囲外です
- 公開は2026年9月16日で、Google AI検索の仕組みは月単位で変わっています
私がこの調査を評価しているのは、数値の精度ではなく、130人の実務家が「AI固有の小技より、読めること・合っていること・知られていることが上」で一致した点です。方向の合意として使い、個別の数値に頼りすぎないのが正しい距離感です。
よくある質問(FAQ)
Google AI検索のランキング要因で最も重要なものは何ですか?
Zyppyの専門家調査(2026年9月)では、AIクロール到達性・スニペット適格性が+2.20で1位、クエリと回答の一致が+2.15で2位、LLMの記憶にあるブランド・エンティティが+2.08で3位でした。Googleがページを読めて、質問に直接答えていて、ブランドが既に知られていること、の3つです。
構造化データはAI Overviewsに効きますか?
専門家の評価は+0.80で、上位要因(+1.65〜+2.20)の半分以下でした。Googleも公式ガイドでAI OverviewsとAI Modeに特別なschemaは不要と明言しています。例外は商品・販売者データで、AI Modeのショッピング結果には効くとされています。
llms.txtは設置すべきですか?
Google AI検索の引用への影響は+0.05で、事実上ゼロと評価されました。約50万ドメインを対象にした複数の調査でもAIボットが自発的に読まないことが確認されています。ただしAIエージェントにサイト構造を渡す用途では使われており、「検索の引用に効かない」と「用途がない」は別です。
オーガニック順位が高ければAI Overviewsに引用されますか?
順位は+1.89、ファンアウトクエリでの順位は+1.91と、どちらも上位要因です。専門家は「引用されるのは順位があるから」と整理していますが、順位は必要条件であって十分条件ではありません。具体的な事実と、ブランドの信頼があわせて必要です。
まとめ:順序を守れば、AI対策の大半は「良いSEO」と重なる
Infinite Visibility GroupのAJ Kohn氏の言葉が、この調査全体をよく表しています。「AIブーム以前からユーザー中心のSEOをやっていたなら、AI検索の環境でも成功する準備はできている」。到達性を確認し、問いに直接答え、ファンアウトを想定して関連トピックを網羅し、一次情報を1つ足し、エンティティとしての一貫性を積む。この順序で進めれば、AI固有の施策は最後に残る小さな部分です。
まず自社の主要クエリでAI Overviewsが出ているか、誰が引用されているかを確認するところから始めてください。
LinkSurgeのAI Overview分析機能では、キーワードごとのAI Overviews出現状況と引用元を確認でき、クエリファンアウト分析では主要クエリがどんなサブクエリに分解されるかを把握できます。