ChatGPTはどこから情報を持ってくるのか — 「学習した知識」と「その場で検索した情報」の違い
目次
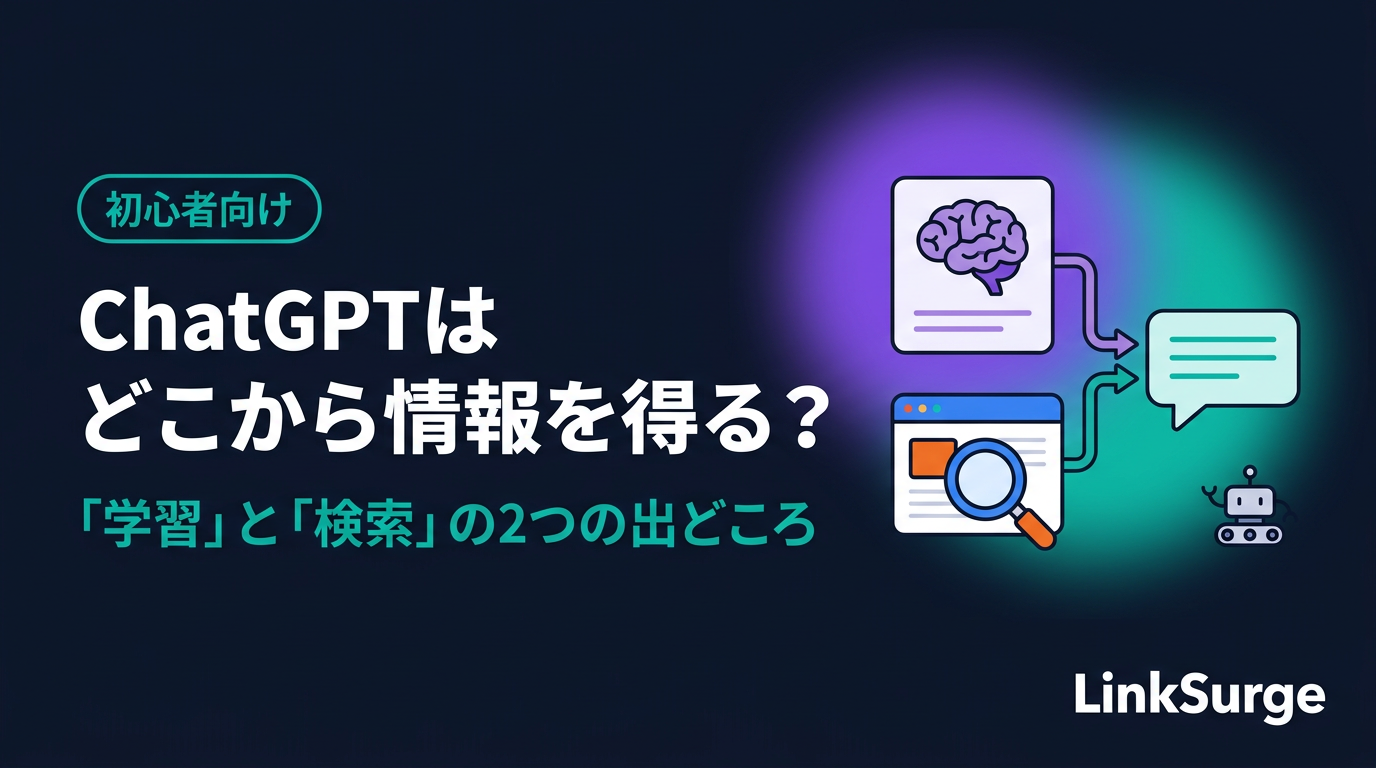
この記事の結論:ChatGPTの答えには「覚えていること」と「調べたこと」の2つの出どころがある
「ChatGPTは、どこからこの情報を持ってきたのだろう」。使っているうちに、一度は気になる疑問です。私がOpenAIの公式ヘルプとクローラー(ウェブを巡回するプログラム)の説明を読み直して整理したところ、要点は次の4つでした。
- 出どころは大きく2つある — 1つは、事前に大量の情報から学んだ「学習データ」。もう1つは、質問を受けたその場でウェブを調べる「ウェブ検索」です。前者は頭の中の知識、後者はその場で開く参考書にあたります
- 学習データには「いつまで」の区切りがある — OpenAIは、公開されたウェブの情報・提携先から得た情報・利用者やトレーナーが提供した情報の3つでモデルを開発していると説明しています。学習した後の出来事は、そのままでは知りません
- 最新の情報はウェブ検索で補う — ChatGPTは、最新情報が役立つ質問では自動でウェブを検索することがあり、その回答には情報源へのリンク(引用)が付くことがあります
- サイト運営者が見るべきクローラーは用途ごとに違う — 学習用は「GPTBot」、検索に表示するためのものは「OAI-SearchBot」です。設定は互いに独立しており、学習を断っても検索に出ることはできます
以下では、2つの出どころを順に見たうえで、サイト運営者として何を確かめればよいかを整理します。
1. ChatGPTの答えには2つの出どころがある
最初に全体像をつかみましょう。ChatGPTを「とても物知りな人」にたとえると分かりやすくなります。
この人は、何年もかけて大量の本や文章を読み、知識を身につけています。普段の質問には、その知識だけで答えます。ところが「今日のニュースは?」「最新の料金は?」と聞かれると、頭の中の知識では足りません。そこでスマートフォンを取り出して調べ、調べた結果を見ながら答えます。
| 出どころ | ChatGPTでの呼び名 | たとえると | 答えの特徴 |
|---|---|---|---|
| 1 | 学習データ(トレーニングデータ) | これまでに読んで身につけた知識 | 情報源のリンクは付かない。学習した時点より新しいことは知らない |
| 2 | ウェブ検索(ChatGPT search) | その場でスマートフォンで調べた結果 | 情報源へのリンク(引用)が付くことがある。最新情報に対応できる |
この2つは、混ざって使われることもあります。身につけた知識で話の筋を組み立てつつ、細かい事実は調べた結果で補う、という具合です。
なぜ出どころを区別する必要があるのか
サイト運営者から見ると、2つの出どころは「自分のサイトが関わる経路」がまったく違います。学習データに入るかどうかと、検索で読まれて引用されるかどうかは、別々の仕組みで決まるからです。この違いを知らないまま対策を考えると、的外れな設定をしてしまいます。後半でその具体例も紹介します。
参考・引用: ChatGPTと当社の基盤モデルの開発方法 - OpenAI Help Center ChatGPT でウェブを検索する - OpenAI Help Center
2. 出どころ1:学習データ — 事前に読んで身につけた知識
学習データとは、AIのモデル(ChatGPTの頭脳にあたるプログラム)を作るときに読ませる大量の情報のことです。OpenAIは、ChatGPTを動かすモデルを含む基盤モデルを、次の3つの情報源から開発していると説明しています。
- インターネット上で公開されている情報 — 誰でも見られるウェブページ、公開されたフォーラム(掲示板)、ブログ、投稿など
- 提携先から得た情報 — 第三者との契約を通じて利用するデータ
- 利用者・トレーナー・研究者が提供または生成した情報 — 人がモデルの改善のために作ったデータなど
どんなウェブの情報が学習に使われるのか
OpenAIのヘルプによると、公開されたインターネット上の情報のうち、自由に見られるものだけを使うとしています。有料会員限定の記事など、ペイウォール(料金を払わないと読めない壁)の向こうにあると分かっている情報源から意図的に集めることはしない、とも書かれています。さらに、ヘイトスピーチ、アダルトコンテンツ、個人情報を集めたサイト、スパム(迷惑な目的のページ)などはフィルターで取り除いているそうです。
モデルは文章をそのまま保存しているのか
ここは誤解が多いところです。OpenAIは、モデルは学習したデータのコピーを保存・保持しておらず、学習データから「コピー&ペースト」しているわけではないと説明しています。言葉どうしの関係のパターンを学び、次に来る可能性が高い言葉を1語ずつ予測して文章を作っている、というのが公式の説明です。
この仕組みのため、同じ質問でも答えが毎回少しずつ変わることがあると、OpenAI自身が書いています。私も同じ質問を何度か試すと、言い回しや挙げる例が変わる場面によく出会います。
学習データには「いつまで」の区切りがある
学習データは、ある時点までに集めた情報で作られます。OpenAIの開発者向けドキュメントでは、モデルごとに「Knowledge cutoff(知識の区切り)」という日付が示されています。その日付より後の出来事は、学習データだけでは答えられません。
料金改定や新商品の発売など、最近の変化を学習データだけで正しく答えられないのはこのためです。
自分のサイトを学習に使わせないことはできるのか
できます。OpenAIは、学習に使う可能性のある公開コンテンツを集めるクローラーとして「GPTBot」を公開しています。サイトの robots.txt(クローラーにどこを巡回してよいかを伝えるファイル)でGPTBotを拒否すると、そのサイトの内容を学習に使わないでほしいという意思表示になります。
参考・引用: ChatGPTと当社の基盤モデルの開発方法 - OpenAI Help Center Models - OpenAI API Docs Overview of OpenAI Crawlers - OpenAI API Docs
3. 出どころ2:ウェブ検索 — 質問のたびにその場で調べる情報
学習データの弱点を補うのが、ウェブ検索です。OpenAIのヘルプでは、ChatGPTはウェブを検索して、最新の情報と関連する情報源へのリンクを使って質問に答えられると説明されています。
ChatGPTはいつウェブを検索するのか
検索のきっかけは2つあります。
- 自動で検索する — 質問への回答に最新情報が役立つ場合、ChatGPTは自動的にウェブを検索することがあります
- 自分で検索を指示する — ツールの一覧から「検索」を選ぶか、入力欄に「/」と入れて「検索」を選ぶと、検索を使った回答になります
つまり、同じChatGPTでも、質問によって「知識だけで答える」場合と「調べてから答える」場合があるわけです。
質問はそのまま検索されるわけではない
面白いのは、検索の中身です。ヘルプによると、ChatGPTは他の検索サービスと連携することがあり、その際は入力された質問を、対象を絞った1つ以上の検索クエリ(検索窓に入れる言葉)に書き換えて送ります。
ヘルプの例では、「がん治療用のCCR8標的薬の開発に関する最新情報は?」という質問が、まず「CCR8 免疫療法 薬剤開発 2025」という検索に書き換えられています。結果を見たうえで、さらに具体的な検索を別の検索サービスに送ることもあるそうです。人間が調べものをするときに、言葉を変えながら何度か検索するのと似ています。
連携先の詳細は公開されていませんが、ヘルプでは検索サービスのプライバシーポリシーとして Microsoft と Shopify のものが案内されています。
回答のどこを見れば出どころが分かるのか
ウェブ検索を使った回答には、引用が付くことがあります。引用を選ぶと情報源のページが開き、「情報源」を選ぶと引用元やその他の関連リンクを一覧で確認できます。
OpenAIはヘルプの中で、検索結果や引用は不完全・古い・誤っている場合があると明記しています。引用元を開いて回答を裏付けているかを確かめ、公開日や更新日も確認するよう案内しています。引用が付いているからといって、正しさが保証されるわけではないのです。
どんなサイトが検索結果に出るのか
ヘルプによると、ChatGPTは利用者が関連性と信頼性の高い情報を見つけられるよう、複数の要素で検索結果を順位付けしています。表示される位置は保証されていません。
サイトが検索結果に含まれる対象になるには、「OAI-SearchBot」というクローラーの巡回を許可し、サーバーやCDN(配信を速くするための仕組み)がOpenAIの公開しているIPアドレスからの通信を受け付けている必要があります。
ChatGPT検索の内部構造をもっと詳しく知りたい方は「ChatGPT検索の内部構造」で、複数の検索の仕組みがどう組み合わさっているかを解説しています。
参考・引用: ChatGPT でウェブを検索する - OpenAI Help Center Overview of OpenAI Crawlers - OpenAI API Docs
4. サイト運営者が知っておきたいOpenAIのクローラー
2つの出どころを押さえたところで、サイト運営者にとって一番実用的な話に進みます。OpenAIのドキュメントでは、用途の違うクローラーが紹介されています。
| クローラー名 | 何のために来るか | robots.txtで拒否すると |
|---|---|---|
| GPTBot | 学習に使う可能性のある公開コンテンツを集める | 学習に使わないでほしいという意思表示になる |
| OAI-SearchBot | ChatGPTの検索機能にサイトを表示するために巡回する | ChatGPT検索の回答に表示されなくなる(案内用のリンクとして出ることはある) |
| ChatGPT-User | 利用者の質問に答えるため、その場でページを見に行く | 利用者の操作がきっかけのため、robots.txtの規則が適用されない場合がある |
| OAI-AdsBot | ChatGPTの広告として申請されたページを確認する | 広告として申請されたページだけを訪れる |
ドキュメントを読んで私が一番大事だと感じたのは、GPTBotとOAI-SearchBotの設定は互いに独立しているという点です。OpenAIのドキュメントでも、それぞれ独立して動作すると書かれています。そのため、「学習には使わないでほしいが、ChatGPTの検索には出たい」という設定ができます。
たとえば robots.txt に次のように書くと、GPTBotだけを拒否し、OAI-SearchBotは許可する意味になります。
User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Allow: /
OpenAIは、robots.txtを更新してから検索に反映されるまで約24時間かかると案内しています。設定を変えた翌日に確認するくらいの気持ちでいましょう。
なお、両方のクローラーを許可している場合、OpenAIは一度のクロール結果を両方の目的に使うことがあるとも説明しています。
5. Googleの話と混ぜないために
ここで一度、Googleとの違いを整理しておきます。AI検索の話題では、ChatGPTとGoogleの話が混ざって語られがちだからです。
GoogleのAI Overviews(検索結果の上に出るAIの回答)やAIモードは、Googleの検索インデックス(Googleが集めたページの目録)をもとに動いています。Googleは公式ガイドで、これらに表示されるための追加の要件はなく、特別な最適化も必要ないと説明しています。巡回するのも、通常の検索と同じGooglebotです。
一方、ChatGPTの検索は、OpenAIのクローラーと連携先の検索サービスを使う、別の仕組みです。つまり、次の2つは別々に確かめる必要があります。
- Googleの検索とAI機能 — Googlebotが巡回でき、Googleのインデックスに登録されているか
- ChatGPTの検索 — OAI-SearchBotが巡回できるか
Google側の基本は、シリーズの「AI Overviewsとは」や「検索エンジンはどう動くのか」で解説しています。
6. よくある誤解・失敗例
仕組みが分かると、よくある勘違いの理由も見えてきます。初心者がつまずきやすい5つを紹介します。
誤解1:「ChatGPTはインターネットを丸ごと覚えていて、最新のことも知っている」
学習データには区切りの日付があり、その後の出来事は学習データだけでは答えられません。最新の情報が必要な質問では、ウェブ検索を使った回答かどうか、引用が付いているかを確かめましょう。
誤解2:「GPTBotを拒否したら、ChatGPTの検索にも出なくなる」
GPTBotは学習用、OAI-SearchBotは検索用で、設定は独立しています。学習を断るつもりで「OpenAIのクローラーを全部拒否」すると、検索にも出なくなってしまいます。私がrobots.txtの書き方を見ていて一番もったいないと感じるのが、このパターンです。止めたいのはどちらなのかを決めてから設定しましょう。
誤解3:「引用が付いている答えなら、内容は正しい」
OpenAI自身が、検索結果や引用は不完全・古い・誤っている場合があると書いています。引用元を開いて、本当にそう書いてあるか、いつの情報かを確かめる習慣をつけましょう。
誤解4:「一度確認すれば、ChatGPTでの見え方はずっと同じ」
答えは毎回少しずつ変わりますし、引用元も入れ替わります。第三者の計測では、2026年8月にChatGPTの引用元の構成が数日で大きく変わったことも報告されています。詳しくは「ChatGPTの引用元は4日で86%動く」をご覧ください。1回の確認で判断せず、同じ質問で繰り返し記録することをおすすめします。
誤解5:「Googleで上位なら、ChatGPTにも必ず出る」
ChatGPTの検索は別の仕組みで、OpenAIも表示位置は保証されないと説明しています。Googleでの評価とChatGPTでの見え方は、別々に確かめる必要があります。
7. 自分のサイトで確かめるには
最後に、自分のサイトがChatGPTからどう扱われているかを確かめる手順です。
- robots.txtを確認する — 自分のサイトのURLの後ろに「/robots.txt」を付けて開き、GPTBotとOAI-SearchBotがどう書かれているかを見ます。検索に出たいのにOAI-SearchBotを拒否していないか、まずここを確認しましょう
- ChatGPTで検索を使って質問してみる — 自分の業種やサービスに関係する質問を、検索を有効にして投げます。回答の「情報源」に自分のサイトが入っているか、どんなサイトが並んでいるかを見ます
- 同じ質問で記録を続ける — 答えは変わるので、決めた質問を定期的に確かめ、結果を残します
3つ目を手作業で続けるのは大変です。LinkSurgeのGEOモニタリングのように、ChatGPTを含む複数のAIに同じ質問を自動で投げ、回答の中で自社が言及・引用されているかを記録するツールを使う方法もあります。どんなドメインがChatGPTに引用されやすいかの全体像は「ChatGPTが日本語で引用するドメインの構造」で解説しています。
自社の名前がAIの回答に出てくるかどうかに関心がある方は、シリーズの「指名検索とブランド言及がAI時代に重要になる理由」もあわせてどうぞ。LinkSurgeのような計測ツールと、自分の目での確認を組み合わせると、見え方の変化に気づきやすくなります。
LinkSurge
linksurge.jp
SEO・AIO・GEO統合分析プラットフォーム。AI Overviews分析、SEO順位計測、GEO引用最適化など、生成AI時代のブランド露出を最大化するための分析ツールを提供しています。
確認チェック
問1:ChatGPTの答えの2つの出どころは何ですか?
答え:事前に大量の情報から学んだ「学習データ」と、質問を受けたその場でウェブを調べる「ウェブ検索」の2つです。
問2:GPTBotをrobots.txtで拒否すると、ChatGPTの検索結果にも出なくなりますか?
答え:なりません。GPTBotは学習用のクローラーで、検索に表示するためのOAI-SearchBotとは設定が独立しています。検索に出なくなるのは、OAI-SearchBotを拒否した場合です。
問3:ChatGPTが最近の出来事を正しく答えられないことがあるのはなぜですか?
答え:学習データには区切りの日付があり、その後の出来事は学習データだけでは分からないからです。ウェブ検索を使った回答なら、最新の情報で補えることがあります。
よくある質問(FAQ)
ChatGPTは毎回インターネットを検索して答えているのですか?
毎回ではありません。OpenAIのヘルプによると、最新情報が役立つ質問では自動でウェブを検索することがあり、利用者が手動で検索を選ぶこともできます。検索を使わない回答は、事前に学習した知識をもとに作られます。
ChatGPTの回答に自分のサイトが引用されるには何が必要ですか?
OpenAIは、OAI-SearchBotの巡回を許可し、サーバーやCDNがOpenAIの公開IPアドレスからの通信を受け付けていることを、検索結果に含まれる条件として挙げています。そのうえで、ChatGPTは複数の要素で結果を順位付けしており、表示位置は保証されていません。
自分のサイトをChatGPTの学習に使われたくない場合はどうすればいいですか?
robots.txtでGPTBotを拒否します。OpenAIは、GPTBotを拒否することが、そのサイトの内容を基盤モデルの学習に使わないでほしいという意思表示になると説明しています。OAI-SearchBotを許可したままにすれば、検索には表示される対象のままです。
ChatGPTは学習した文章をそのまま答えに使っているのですか?
OpenAIは、モデルは学習データのコピーを保存しておらず、コピー&ペーストしているわけではないと説明しています。学んだ言葉のパターンをもとに、次に来る可能性が高い言葉を予測して文章を作っています。そのため、同じ質問でも答えが変わることがあります。
まとめ:まず「学習」と「検索」を分けて考える
ChatGPTについて調べたり対策を考えたりするときは、最初に「これは学習データの話か、ウェブ検索の話か」を分けてみてください。学習に使われたくないならGPTBot、検索に出たいならOAI-SearchBot。この区別だけで、よくある設定ミスはかなり防げます。
次にやることは、自分のサイトのrobots.txtを開いて、2つのクローラーの扱いを確かめることです。そのうえで、ChatGPTに自分の分野の質問をして、どんな情報源が並ぶかを見てみましょう。
この記事の前に読む記事は「AIで書いた記事はGoogleに嫌われるのか」、次に読む記事はGoogleのAI機能を扱う「AIモードとは」です。シリーズ全体の順番は「SEO・GEO・AIO 入門カリキュラム」、言葉に迷ったら「SEO用語集」をご覧ください。ChatGPT対策の全体像を知りたくなったら「ChatGPTに引用される方法 完全ガイド2026」が次の一歩になります。
LinkSurgeのGEOモニタリングでは、ChatGPTを含む複数のAIに同じ質問を定期的に投げ、自社が言及・引用されているかを記録できます。